X XFediYour place in the Fediverse
XFEDI

Conversation

ActivityPub

Niedawno dzieliłem się statystykami mojego pipeline'u do generowania list blokad DNS. Od tamtej pory przeszedł on solidną metamorfozę.

Zamiast formatu Adblock, pobieram teraz listy w czystych domenach i formacie dnsmasq. Dorzuciłem też dwa potężne źródła skoncentrowane na phishingu: Cert Polska (NASK) oraz Phishing Army.

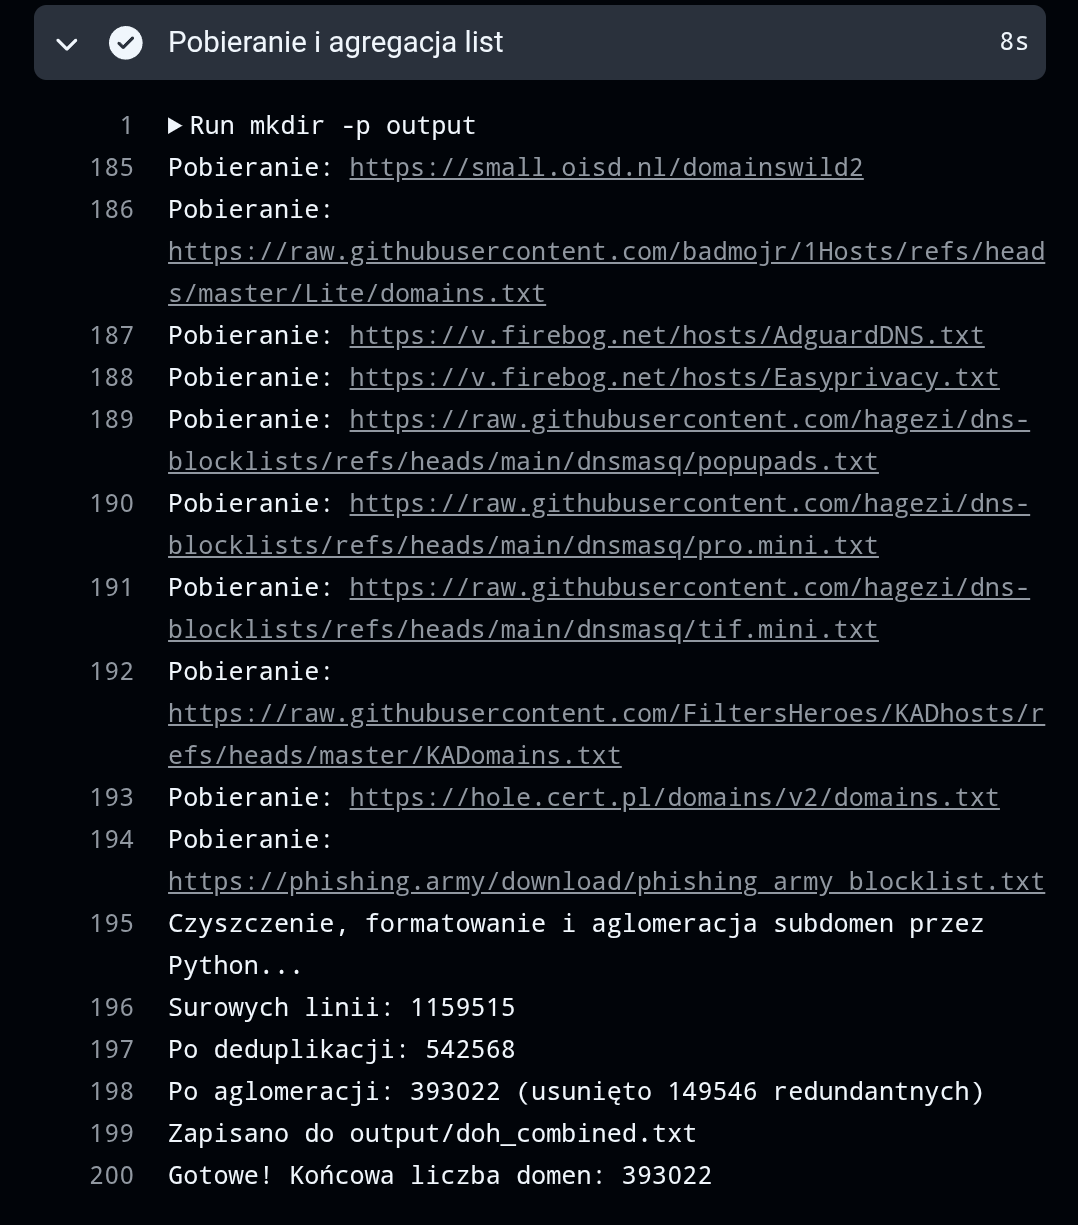
Efekt? Z 1,15 miliona surowych linii powstała końcowa lista 393 tysięcy domen. Oznacza to, że cały proces odrzucił aż 66% danych wejściowych.

Najpierw deduplikacja wycięła dokładnie te same wpisy, które powtarzały się w różnych listach (zostało 542 tys.). Później aglomeracja wyrzuciła kolejne 149 tysięcy redundantnych subdomen. Skoro blokujemy domena.pl, nie ma sensu trzymać w pliku osobno wpisów dla reklama.domena.pl czy tracking.domena.pl.

Mniejszy plik, szybszy resolver i realna ochrona przed polskim oraz globalnym phishingiem.
#serverless #dns #privacy #cybersec

Zrzut ekranu z logów GitHub Actions. Widać listę pobieranych źródeł, a poniżej statystyki: 1 159 515 surowych linii, 542 568 po deduplikacji oraz 393 022 po aglomeracji (usunięto 149 546 redundantnych wpisów).
↩ Reply ♡ 0 · ↻ 0 ↗ Original

Oct 24, 2026 · 20:03 UTC

Replies
↳ In reply to a post

A skoro mowa o optymalizacji, to właśnie dodałem do tego miksu polską listę MajkiIT (reklamy i trackery).

Ciekawostka z ostatniego builda: z 1242 surowych linii, po odcięciu duplikatów i redundantnych subdomen, do głównej bazy weszły dokładnie 294 nowe, unikalne domeny.

To pokazuje, jak szalony jest ten proces filtrowania. Mniej znane, lokalne listy wnoszą bardzo konkretną, celowaną wartość, a aglomeracja dbają o to, żeby plik nie puchł bez potrzeby.

↩ Reply ♡ 0 · ↻ 0 ↗ Original